Browsing "Older Posts"

Browsing Category "SQL"

Dynamic LOV with Pipeline function

Von Tobias Arnhold → 1.18.2018
A new year brought me some new tasks. I had to take over a generic Excel import and the customer wanted some extension by checking if the join on the master tables were successful.

Unfortunate we were talking about a generic solution which meant that all the configuration was saved inside tables including the LOV-tables which were saved as simple select statements.

Goal:
Show all import rows/values which were not fitting towards the master data.

How did I fix it?


Source of LOV data:

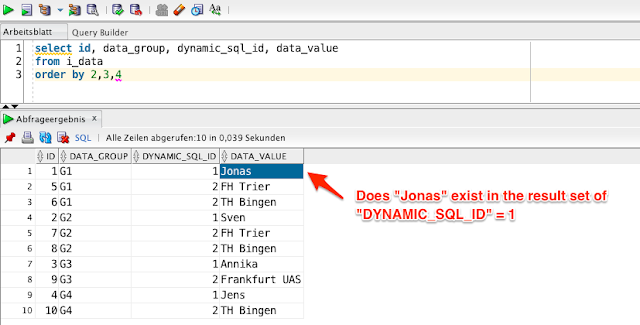
Source of import data:

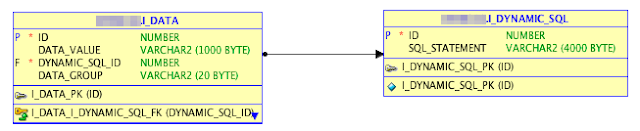
I made a little abstract data model so that you understand what I mean:
I have two tables "I_DATA" including the values from the import and "I_DYNAMIC_SQL" including the LOV statements.
-- ddl
  CREATE TABLE "I_DYNAMIC_SQL" 
   ( "ID" NUMBER NOT NULL ENABLE, 
 "SQL_STATEMENT" VARCHAR2(4000), 
  CONSTRAINT "I_DYNAMIC_SQL_PK" PRIMARY KEY ("ID")
  USING INDEX  ENABLE
   ) ;

  CREATE TABLE "I_DATA" 
   ( "ID" NUMBER NOT NULL ENABLE, 
 "DATA_VALUE" VARCHAR2(1000), 
 "DYNAMIC_SQL_ID" NUMBER, 
 "DATA_GROUP" VARCHAR2(20), 
  CONSTRAINT "I_DATA_PK" PRIMARY KEY ("ID")
  USING INDEX  ENABLE
   ) ;

-- data
REM INSERTING into I_DATA
SET DEFINE OFF;
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (1,'Jonas',1,'G1');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (2,'Sven',1,'G2');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (3,'Annika',1,'G3');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (4,'Jens',1,'G4');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (5,'FH Trier',2,'G1');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (6,'TH Bingen',2,'G1');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (7,'FH Trier',2,'G2');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (8,'TH Bingen',2,'G2');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (9,'Frankfurt UAS',2,'G3');
Insert into I_DATA (ID,DATA_VALUE,DYNAMIC_SQL_ID,DATA_GROUP) values (10,'TH Bingen',2,'G4');

REM INSERTING into I_DYNAMIC_SQL
SET DEFINE OFF;
Insert into I_DYNAMIC_SQL (ID,SQL_STATEMENT) values (1,'select d,r from (
   select ''Jonas'' as d, 1 as r from dual union all 
   select ''Sven'' as d, 2 as r from dual union all 
   select ''Jens'' as d, 3 as r from dual union all 
   select ''Annika'' as d, 4 as r from dual
)');
Insert into I_DYNAMIC_SQL (ID,SQL_STATEMENT) values (2,'select d, r
from (
   select ''FH Trier'' as d, 1 as r from dual
   union all
   select ''TH Bingen'' as d, 2 as r from dual
)');

It actually took some time to find a solution fitting my needs.
1. Fast
2. Easy to understand
3. Not tons of code

What I needed was some kind of EXECUTE IMMEDIATE returning table rows instead of single values. With pipeline functions I was able to do it:
create or replace package i_dynamic_sql_pkg as

  /* LOV type */
  type rt_dynamic_lov is record ( display_value varchar2(4000), return_value number );

  type type_dynamic_lov is table of rt_dynamic_lov;

  function get_dynamic_lov (
    p_lov_id number
  ) return type_dynamic_lov pipelined;
end;

create or replace package body i_dynamic_sql_pkg as
  /* global variable */
  gv_custom_err_message varchar2(4000);

  /* Function to return dynamic lov as table */
  function get_dynamic_lov (
    p_lov_id number
  ) return type_dynamic_lov pipelined is

    row_data rt_dynamic_lov;

    type cur_lov is ref cursor;
    c_lov cur_lov;

    e_statement_exist exception;

    v_sql varchar2(4000);
  begin

    -- 'Exception check - read select statement';
    select 
       max(sql_statement)
    into
       v_sql
    from i_dynamic_sql
    where id = p_lov_id;

    -- 'Exception check - result';
    if v_sql is null
    then
      gv_custom_err_message := 'Error occured. No list of value found.';
      raise e_statement_exist;
    end if;

    -- 'Loop dynamic SQL statement';
    open c_lov for v_sql;
    loop
       fetch c_lov 
       into 
         row_data.display_value,
         row_data.return_value;
       exit when c_lov%notfound;

       pipe row(row_data);
    end loop;
    close c_lov;

  exception
  when e_statement_exist then
      rollback;
      /*
      apex_error.add_error(
        p_message => gv_custom_err_message
      , p_display_location => apex_error.c_inline_in_notification
      );
      */
      raise_application_error(-20001, gv_custom_err_message); 
  when others then
      raise;
  end;
end;

Now I just had to create a SQL statement doing the job for me:
-- ddl
select
  da.data_group,
  da.data_value,
  /* check if a return value exist */
  case
    when lov.display_value is not null
    then 'OK'
    else 'ERROR'
  end as chk_lov_data_row,
  /* apply error check for the whole group */
  case
    when min(case
                when lov.display_value is not null
                then 1
                else 0
              end) over (partition by da.data_group)
        = 0
    then 'ERROR'
    else 'OK'
  end as chk_lov_data_group
from i_data da
/* Join on my pipeline function including the dynamic sql id */
left join table(i_dynamic_sql_pkg.get_dynamic_lov(da.dynamic_sql_id)) lov
on (da.data_value = lov.display_value)
order by da.data_group, da.dynamic_sql_id, da.data_value;

Result:

The best Oracle technology week ever - Part 1: Helsinki and Stockholm

Von Tobias Arnhold → 9.07.2017
You remember my last blogpost describing how my #europeTour would be like:
#orclapex Europe tour 

It was a week with as little sleep as possible. Reasons:
 - traveling
 - just was to excited
 - to much party

It all started in Helsinki with the first Oracle APEX day in Finland.
I reached Helsinki with Richard Rieb around 10 o'clock in the evening. It was dark and cold, our taxi driver spoke 5 words to us but good hard rock music was played on the radio. We knew we have come to the right place.
At the next day we met the organizers (Heli and Marko), the other speakers (Carsten Czarski, Shakeeb Rahman, Matthias Nöll and Mathias Magnussen) and 30 other APEX interested people.
I was happily surprised to meet Matt Nolan from the FOEX crew.
Background story: This guy gave me, in hard times maybe 8 years ago, some good tips and kept my APEX passion alive.
I was even more surprised to meet Jari Lainen which created a really nice APEX example application and has an awesome blog as well. He mentioned to join a new APEX project soon. He will hopefully start writing then again.

The presentations were really good but see for yourselves:


Btw: If you think I do crazy stuff then I always find someone even more devoted like Heli who flew to Soul for the Oracle code conference in between the Finnish APEX event and the POUG in Krakow.

We the other presenters, except Mathias who had to fill the time gaps in between the conferences, took the cruiser ship to Stockholm.


Funny fact: beer at the bar was 6 €, one beer at the tax free shop costs 3,50 € and 24 for of them in a pack costs 20 €. You know what we did.

We enjoyed beers in a stormy night at the railing watching the ocean.
Tip: On a shaky boat just drink 5 beers and feels like you have drunken 10.

In Stockholm we got the perfect location including really tasty food during the first Oracle APEX day in Sweden. 60 participants were listening to our presentation. See for yourselves:


We got great feedback by the customers and enjoyed several nice talks. I even talked to a guy from Denmark who just came to participate at this particular conference. Thanks to the Swedish Oracle Usergroup (SWEOUG) making it possible. My special thanks goes to Daniel and Mathias.

We spent the night by my relatives as Richard discoverd that one of the beers got broken and drenched his backpack. :D Luckily he flew home the day after.

Next Morning at 5 o'clock we (Matthias and me) headed towards the Arlanda airport and took the flight to Berlin.
In Berlin we met the students for the "NextGEN goes POUG trip" (#pougtrip)

In case you want to look at all the tweets from the conference then search for #europeTour, #sweougApex17 or #orclapex.

Next time I will tell you all about the trip to the "POUG 2017". :) Look closely at the DOAG website.

SQL Developer: Quick Outline with SQL statements

Von Tobias Arnhold → 11.30.2016
Most of you probably know the "Quick Outline" function you have inside the SQL Developer.
It helps you to easily jump between different functions/procedures inside a package.


My colleague Holger told me about a bug in SQL Developer 3.x where you could use the "Outline" view with normal SQL files, too. Unfortunately in version 4 it didn't work anymore. So he stayed with version 3 for a long while. Otherwise he would had to scroll again instead of a short jump towards a specific SQL select.


A few days ago he asked me again if I knew a way how to easily jump between SQL statements inside a SQL file.
So I thought I talk to a SQL developer specialist "Sabine Heimsath". She knows all about those little tricks I have no clue about. But Sabine didn't know how to do it either.

My last chance was to ask on Twitter about a proper solution.

Even on Twitter nobody answered me. I guess they just started to implement such a feature. :)

Anyway yesterday Holger told me that he found a way to get it to run on SQL Developer 4.1.
Reason enough for me to share the awesome idea.

create or replace package body "" as 
/* ************************************************************************************************************************************************ */
function "SQL example 1";
/
-- SQL Statement

/* ************************************************************************************************************************************************ */
function "SQL example 2 - no character capping";
/
-- SQL Statement

/* ************************************************************************************************************************************************ */
function SQL_example_3_without_double_quote;
/
-- SQL Statement

end;


Finally a little GIF movie showing you the usage in action:

Tablespaces verkleinern (TEMP, USER_TS, ORA-03297)

Von Tobias Arnhold → 11.28.2016

Info
Die Select-Statements in diesem Blogpost habe ich von anderen Webseiten kopiert. Daher ist dieser Beitrag eher als Zusammenfassung unterschiedlicher Lösungsversuche zu sehen und dient mir als schnelle Hilfe bei der Verkleinerung eines zu großen Tablespaces. Schaut euch die Quellen an, die sehr viel detaillierter auf die jeweiligen Probleme eingehen.

Wer kennt nicht die Situation? Der DBA ruft an und meint der TEMP Tablespace verbraucht mehrere hundert Gigabyte an Speicher.

Was ist in solch einer Situation zu tun?
In dem Moment wo ein TEMP Tablespace überproportional ansteigt, muss eine Session diesen Anstieg verursachen. Mit dem folgenden Select erfahren Sie welche Session wie viel Speicher im TEMP-Tablespace verbraucht.

-- Source: http://stackoverflow.com/questions/174727/discover-what-process-query-is-using-oracle-temp-tablespace
select   b.tablespace
       , b.segfile#
       , b.segblk#
       , round (  (  ( b.blocks * p.value ) / 1024 / 1024 ), 2 ) size_mb
       , a.sid
       , a.serial#
       , a.sql_id
       , a.username
       , a.osuser
       , a.program
       , a.status
    from v$session a
       , v$sort_usage b
       , v$process c
       , v$parameter p
   where p.name = 'db_block_size'
     and a.saddr = b.session_addr
     and a.paddr = c.addr
order by b.tablespace
       , b.segfile#
       , b.segblk#
       , b.blocks;

Über die SQL_ID können Sie wenn vorhanden auch auf das Verursacher-Select zugreifen:
-- Source: http://cheatsheet4oracledba.blogspot.de/2014/01/how-to-find-top-temp-using-oracle.html
select sql_text 
from v$sql 
where sql_id='b6kta08q9jj3f';

Über den SQL Developer > Tools > Monitor Sessions können Sie die betroffene SID killen.

Anschließend wird der Verbrauch des TEMP-Tablespace zwar wieder zurückgefahren, aber die Größe bleibt bestehen.

Prüfen Sie daher zunächst die aktuelle verwendete Größe im TEMP-Tablespace:
-- Source: https://alexzeng.wordpress.com/2012/06/13/how-to-find-the-sql-that-using-lots-of-temp-tablespace-in-oracle/
select b.total_mb,
       b.total_mb - round(a.used_blocks*8/1024) current_free_mb,
       round(used_blocks*8/1024)                current_used_mb,
      round(max_used_blocks*8/1024)             max_used_mb
from v$sort_segment a,
 (select round(sum(bytes)/1024/1024) total_mb from dba_temp_files ) b;

-- Oder:
select * from dba_temp_free_space;

Wenn der Wert (current_used_mb) entsprechend klein ist, dann können Sie den TEMP-Tablespace verkleinern, andernfalls haben Sie nicht die richtige Session gekillt.

TEMP-Tablespace verkleinern:
select file_name,bytes,blocks from dba_temp_files;
-- .../tempfile/temp.911 564863696896 68953088

alter tablespace temp shrink space;

select file_name,bytes,blocks from dba_temp_files;
-- ../tempfile/temp.911 289513472 35341


Es kann aber auch vorkommen das eine normaler Tablespace zu groß wurde und dadurch viel mehr Platz verbraucht als es aktuell verwendet.
Um darüber einen Überblick zu erhalten, führen Sie folgendes Select aus:
 -- Source: Nicht mehr bekannt :(
select
   mb.*
  ,nvl(round(100 * freemb / sizemb,1),0) free_prozent
from 
 (select 
    b.tablespace_name
   ,round(tbs_size,2) as sizemb
   ,a.free_space freemb
  from 
    (select 
       tablespace_name
      ,round(sum(bytes)/1024/1024 ,2) as free_space 
     from dba_free_space group by tablespace_name
    ) a
   ,(select 
      tablespace_name, 
      sum(bytes)/1024/1024 as tbs_size 
     from dba_data_files group by tablespace_name
     union
     select 
       tablespace_name, 
       sum(bytes)/1024/1024 tbs_size
     from dba_temp_files
     group by tablespace_name 
    ) b
  where a.tablespace_name(+)=b.tablespace_name
  ) mb
order by free_prozent;

Bei einer solchen Situation muss anstelle des Tablespaces die Datendatei verkleinert werden.
Nun benötigen Sie dafür noch den richtigen Dateinamen, um die korrekte Datei zu verkleinern:
SELECT 
  name, 
  bytes/1024/1024 AS size_mb
FROM   v$datafile
;

Statement zum verkleinern der Datendatei:
ALTER DATABASE DATAFILE '.../DATAFILE/my_schema.033.123331' RESIZE 3G

Die Verkleinerung kann aber in einem ORA-03297 Fehler enden.

ALTER DATABASE DATAFILE '.../DATAFILE/my_schema.033.123331' RESIZE 3G
Error report -
SQL Error: ORA-03297: file contains used data beyond requested RESIZE value

Jetzt bleiben Ihnen 3 Schritte um mit geringem Aufwand diese Datei doch noch zu verkleinern:

1. Fragmentierung bereinigen
Die Datendatei wurde fragmentiert und eine Tabelle liegt am Ende der Datei und verhindert dadurch die Verkleinerung.

Beispiel:
Die Datendatei ist 90 GB groß und tatsächlich werden nur 2 GB verwendet.
Eine Tabelle liegt von der Verteilung her zwischen 82-83 GB. Heißt, ich könnte die Datendatei nur auf 84G verkleinern. Also müssen Sie in solch einem Fall das Objekt ausfindig machen und löschen. Sinnvollerweise kopiere ich vorher die Tabelle in einen anderen Tablespace, um diese anschließend wieder herstellen zu können. :)

Um die Blockverteilung analysieren zu können, muss vorher die richtige File-ID ausgelesen werden:
select 
  s.tablespace_name, s.owner, s.segment_name, s.segment_type,
  sum(s.bytes) size_in_bytes,
  round(sum(s.bytes) / 1024 / 1024, 2) size_in_m,
  sum(round(sum(s.bytes) / 1024 / 1024, 2)) over() as size_in_m_gesamt,
  f.file_id,
  f.file_name
from sys.dba_segments s, sys.dba_data_files f
where f.tablespace_name = s.tablespace_name
and f.file_id = s.header_file
and s.tablespace_name in ('NTDC03')
group by s.tablespace_name, s.owner, s.segment_name, s.segment_type, f.file_id, f.file_name
order by s.tablespace_name, s.owner, s.segment_name;

Das folgende Select zeigt die Blockverteilung mit den verwendeten DB-Objekten innerhalb der Datendatei:
 Source: http://www.orait.de/db_fehler/ora-03297_file-contains-used-data-beyond.html
select 
  file_id,
  block_id, 
  blocks*8192/1024/1024 as mb,
  owner||'.'||segment_name as object_name,
  block_id*8192/1024/1024 as position_mb
from sys.dba_extents
where file_id = 206
union
select 
  file_id, 
  block_id, 
  blocks*8192/1024/1024 as mb, 
  'Free' as object_name,
  block_id*8192/1024/1024 as position_mb
from sys.dba_free_space
where file_id = 206
order by 1,2,3;


Wenn Sie die betroffenen Tabellen gelöscht haben, dann klappt auch die Verkleinerung wieder:  
ALTER DATABASE DATAFILE '.../DATAFILE/my_schema.033.123331' RESIZE 3G 
Database datafile '.../DATAFILE/my_schema.033.123331' altered.

2. Recycle Bin löschen
purge recyclebin;

3. Coalesce Tablespace
alter tablespace fred coalesce;

Info: TEMP Tablespace auf Unlimited setzen
alter database tempfile '.../TEMPFILE/temp.910.901132571' autoextend on next 250m maxsize unlimited;

Using dynamic tooltips in your Interactive Report

Von Tobias Arnhold → 5.31.2016

Inside an Interactive Report (IR) I had a comment column. The comments in this column could become really large and the users wanted the comments to be automatically trimmed if more then 60 characters were displayed. If the user moved the mouse above a trimmed comment then a tooltip should be display including all comment text.

My first idea was to check for existing plugins which could do this job for me. So I searched on apex.world and found the plugin called "APEX Tooltip" developed by Daniel Hochleitner.

The plugin looked great from what I could see in the example application. When I tried it in my application I found out that all comments must be applied manually in the dynamic action.
Not exactly what I needed. :)

Luckily it was really easy to extend the plugin in a way that I could use it in my IR. To achieve what I need I had to update the javascript file: apextooltip.js
// APEX Tooltip functions
// Author: Daniel Hochleitner
// Updated by Tobias Arnhold
// Version: 1.1

// global namespace
var apexTooltip = {
  // parse string to boolean
  parseBoolean: function(pString) {
    var pBoolean;
    if (pString.toLowerCase() == 'true') {
      pBoolean = true;
    }
    if (pString.toLowerCase() == 'false') {
      pBoolean = false;
    }
    if (!(pString.toLowerCase() == 'true') && !(pString.toLowerCase() == 'false')) {
      pBoolean = undefined;
    }
    return pBoolean;
  },
  // function that gets called from plugin
  showTooltip: function() {
    // plugin attributes
    var daThis = this;
    var vElementsArray = daThis.affectedElements;
    var vTheme = daThis.action.attribute01;
    var vContent = daThis.action.attribute02;
    var vContentAsHTML = apexTooltip.parseBoolean(daThis.action.attribute03);
    var vAnimation = daThis.action.attribute04;
    var vPosition = daThis.action.attribute05;
    var vDelay = parseInt(daThis.action.attribute06);
    var vTrigger = daThis.action.attribute07;
    var vMinWidth = parseInt(daThis.action.attribute08);
    var vMaxWidth = parseInt(daThis.action.attribute09);
    var vLogging = apexTooltip.parseBoolean(daThis.action.attribute10);
    // Logging
    if (vLogging) {
      console.log('showTooltip: affectedElements:', vElementsArray);
      console.log('showTooltip: Attribute Theme:', vTheme);
      console.log('showTooltip: Attribute Content:', vContent);
      console.log('showTooltip: Attribute Content as HTML:', vContentAsHTML);
      console.log('showTooltip: Attribute Animation:', vAnimation);
      console.log('showTooltip: Attribute Position:', vPosition);
      console.log('showTooltip: Attribute Delay:', vDelay);
      console.log('showTooltip: Attribute Trigger:', vTrigger);
      console.log('showTooltip: Attribute minWidth:', vMinWidth);
      console.log('showTooltip: Attribute maxWidth:', vMaxWidth);
      console.log('showTooltip: Attribute Logging:', vLogging);
    }
    for (var i = 0; i < vElementsArray.length; i++) {
      var vaffectedElement = daThis.affectedElements.eq(i);
      // call tooltipster plugin
      $(vaffectedElement).tooltipster({
        theme: vTheme,
        content: $(vaffectedElement).find('.rep_complete_comment').html(),
        contentAsHTML: vContentAsHTML,
        animation: vAnimation,
        position: vPosition,
        delay: vDelay,
        touchDevices: false,
        trigger: vTrigger,
        minWidth: vMinWidth,
        maxWidth: vMaxWidth,
        debug: vLogging,
        functionBefore: function(origin, continueTooltip) {
          $(vaffectedElement).trigger('apextooltip-show');
          continueTooltip();
        },
        functionAfter: function(origin) {
          $(vaffectedElement).trigger('apextooltip-hide');
        }
      });
    }
  }
};
Of course I had to update my IR as well.
First I trimmed the comment column and added a new hidden comment column:
SELECT
-- ...
  CASE WHEN LENGTH(COMMENT_COL) > 60 THEN SUBSTR(COMMENT_COL,1,60)||'...' ELSE COMMENT_COL END AS COMMENT_COL,
  COMMENT_COL as COMPLETE_COMMENT_COL,
from my_table
Then I updated the column attributes:
COMMENT_COL as plain text
- Static ID: rep_comment
- HTML Expression:
#COMMENT_COL#<div class="rep_complete_comment">#COMPLETE_COMMENT_COL#</div>


COMPLETE_COMMENT_COL as hidden column


I also had to add a small css snippet in the page attributes > CSS > Inline to hide the complete comment:
.rep_complete_comment {
display: none;
}

And as a last step I had to implement the tooltip plugin after refreshing the IR:
I used an advanced jQuery selector to get only those comments affected which had more then 60 characters.
td[headers='rep_comment']:contains('...')


The result looked like this:


SQL: Texte mit Umlauten und Sonderzeichen normieren

Von Tobias Arnhold → 2.16.2016
Im heutigen Beispiel möchte ich einmal kurz aufzeigen, wie Sie einen Text nach Ihren Bedürfnissen hin normieren können. Ich habe dazu die bekanntesten Länder der Erde in einer WITH Clause zusammengefasst und bilde mir anhand des Namens einen später verwendbaren normierten String.

Der Zielstring muss GROSSGESCHRIEBEN sein und darf keine Umlaute (ÖÜÄöüäß) und Sonderzeichen (, '.()-) beinhalten.

Show all views including a specific string in the source code

Von Tobias Arnhold → 2.02.2016
Seems to be a simple problem and easy to fix. Actually it is not because if you try one of these examples then you will fail:

Oracle Spatial (Teil 3) - Entfernung von Punkten berechnen

Von Tobias Arnhold → 1.27.2016
Im heutigen Blogpost möchte ich kurz anhand eines Beispiels aufzeigen, wie Sie die Entfernung von SDO_GEOMETRY Punkten berechnen können. Hierbei gehe ich auch konkret auf das Problem des Verbindens von zwei Datenmengen anhand einer definierten Entfernung ein.

Importing XML file with invalid character 22 (U+0016)

Von Tobias Arnhold → 1.15.2016
I have to import a set of XML files from time to time. Most of those XML files can be imported with out any problems. But at least one file includes a special character U+0016 which occurs randomly some where inside the file.

When I try to import that file I get this ORA- error message:
ORA-31011: XML-Parsing nicht erfolgreich
ORA-19202: Fehler bei XML-Verarbeitung
LPX-00217: Ungültiges Zeichen 22 (U+0016)
Error at line 39409 aufgetreten

Generierung von Bitlisten mit Hilfe von SQL am Beispiel einer Datum zu Monat Konvertierung

Von Tobias Arnhold → 12.09.2015
Ich hatte vor kurzem die Aufgabe erhalten eine Bitliste auf Basis eines Monats zu generieren.
Bedeutet, ich habe einen String mit 31 Zeichen der je Zeichen den Zustand 1 oder 0 einnehmen kann.
 - 1 steht für aktiv
 - 0 steht für inaktiv

Beispieldaten:
'0000000001010001000000000000000'
'0000000000000000111111000011010'

Um dies anhand eines verständlichen Beispiels zu verifizieren, habe ich mir eine Dienstplan-Tabelle ausgedacht.

SQL: Calculate the past time between two dates in percent

Von Tobias Arnhold → 11.06.2015
Just a simple example how easy APEX can handle this kind of problem.

Example:
We have today the 06.11.2015 (11-06-2015) and we have two date values 01.11.2015 and 30.11.2015.
Now I want to know how much time has past in percent since the beginning (01.11.2015):
Result: 17 %

Custom CSV Export as ZIP file

Von Tobias Arnhold → 10.23.2015
At the beginning of this year I wrote an article about "Custom CSV Export in APEX".

Now I want to extend the solution by an optional ZIP export.

Why?
You can not export several files at the same time with standard APEX features. For that you have to create a ZIP file including all the files you want to download.

I made an example application "Multi CSV Download as ZIP file" where you see a report including all employee columns and the department name. Above the report is a select list where you can filter for departments.

When you select a department and click on EXPORT then you get an CSV file including all employees for the selected department. In case you don't filter you get an ZIP file including a CSV file for each department.


To create the ZIP file I used the AS_ZIP Package created by Anton Scheffer.

Here is code I used to create the CSV/ZIP file.
DECLARE
    -- Blob Conversion Parameter
    L_BLOB           BLOB;
    L_BLOB_FINAL     BLOB;
    L_NAME           VARCHAR2(200); 
    L_NAME_DOWNLOAD  VARCHAR2(200); 
    L_CLOB           CLOB;
    L_DEST_OFFSET    INTEGER := 1;
    L_SRC_OFFSET     INTEGER := 1;
    L_LANG_CONTEXT   INTEGER := DBMS_LOB.DEFAULT_LANG_CTX;
    L_WARNING        INTEGER;
    L_LENGTH         INTEGER;
    
    
    -- CSV Select
    CURSOR c1 IS
      SELECT
       DNAME,
       '"EMPNO"¡"ENAME"¡"JOB"¡"MGR"¡"HIREDATE"¡"SAL"¡"COMM"' 
         || CHR(13)|| CHR(10) 
         || XMLCAST(XMLAGG(XMLELEMENT(E,COL_VALUE||CHR(13)||CHR(10))) AS CLOB) AS CLOB_VAL
      FROM  (
            SELECT
              DNAME,
              '"'||EMPNO||'"¡"'||ENAME||'"¡"'||JOB||'"¡"'||MGR||'"¡"'||HIREDATE||'"¡"'||SAL||'"¡"'||COMM||'"' as COL_VALUE
            FROM EMP E
            JOIN DEPT D 
            ON (E.DEPTNO = D.DEPTNO)
            WHERE :P1_DEPT IS NULL
            OR    D.DEPTNO = :P1_DNAME
      ) 
      GROUP BY 
        DNAME
      ;
BEGIN
    if :P1_DNAME is null then
   
      for rec in c1 loop    
        DBMS_LOB.createtemporary(L_BLOB, FALSE);
        L_DEST_OFFSET    := 1;
        L_SRC_OFFSET     := 1;
        L_LANG_CONTEXT   := DBMS_LOB.DEFAULT_LANG_CTX;
        L_WARNING        := null;
      
        -- tranform the input CLOB into a BLOB of the desired charset
        DBMS_LOB.CONVERTTOBLOB( DEST_LOB     => L_BLOB,
                                SRC_CLOB     => rec.CLOB_VAL,
                                AMOUNT       => DBMS_LOB.LOBMAXSIZE,
                                DEST_OFFSET  => L_DEST_OFFSET,
                                SRC_OFFSET   => L_SRC_OFFSET,
                                BLOB_CSID    => NLS_CHARSET_ID('WE8MSWIN1252'),
                                LANG_CONTEXT => L_LANG_CONTEXT,
                                WARNING      => L_WARNING
                              );
    
         L_NAME := 'EXPORT_' || trim(to_char(rec.DNAME)) || '.csv';
    
         AS_ZIP.add1file (  P_ZIPPED_BLOB => L_BLOB_FINAL,
                  P_NAME => L_NAME,
                  P_CONTENT => L_BLOB
                  ) ;  
    
         -- dbms_lob.freetemporary(L_BLOB);
      end loop; 
  
      L_NAME_DOWNLOAD := 'EXPORT_ALL.zip';
      AS_ZIP.finish_zip (  P_ZIPPED_BLOB => L_BLOB_FINAL) ;  
    
    else
      for rec in c1 loop    
        DBMS_LOB.createtemporary(L_BLOB_FINAL, FALSE);
      
        -- tranform the input CLOB into a BLOB of the desired charset
        DBMS_LOB.CONVERTTOBLOB( DEST_LOB     => L_BLOB_FINAL,
                                SRC_CLOB     => rec.CLOB_VAL,
                                AMOUNT       => DBMS_LOB.LOBMAXSIZE,
                                DEST_OFFSET  => L_DEST_OFFSET,
                                SRC_OFFSET   => L_SRC_OFFSET,
                                BLOB_CSID    => NLS_CHARSET_ID('WE8MSWIN1252'),
                                LANG_CONTEXT => L_LANG_CONTEXT,
                                WARNING      => L_WARNING
                              );
    
         L_NAME_DOWNLOAD := 'EXPORT_' || trim(to_char(rec.DNAME)) || '.csv';
    
         exit;
      end loop; 
    end if;

    -- determine length for header
    L_LENGTH := DBMS_LOB.GETLENGTH(L_BLOB_FINAL);  

    -- first clear the header
    htp.flush;
    htp.init;

    -- create response header
    OWA_UTIL.MIME_HEADER( 'application/zip', FALSE);
    htp.p('Content-length: ' || L_LENGTH);
    htp.p('Content-Disposition: attachment; filename="'||L_NAME_DOWNLOAD||'"');
    htp.p('Set-Cookie: fileDownload=true; path=/');

    OWA_UTIL.HTTP_HEADER_CLOSE;
    -- download the BLOB
    WPG_DOCLOAD.DOWNLOAD_FILE( L_BLOB_FINAL );

    -- stop APEX
    APEX_APPLICATION.STOP_APEX_ENGINE;
  EXCEPTION
    WHEN OTHERS THEN
      if :P1_DNAME is null then
        DBMS_LOB.FREETEMPORARY(L_BLOB);
      end if;
      DBMS_LOB.FREETEMPORARY(L_BLOB_FINAL);
      RAISE;
END;


Updated 27.08.2018:
Old logic: DBMS_XMLGEN.CONVERT(XMLAGG(XMLELEMENT(E,COL_VALUE||CHR(13)||CHR(10))).EXTRACT('//text()').GETCLOBVAL(),1) AS CLOB_VAL
New logic since 12.1: XMLCAST(XMLAGG(XMLELEMENT(E,COL_VALUE||CHR(13)||CHR(10))) AS CLOB) AS CLOB_VAL

SQL Probleme und das Oracle SQL Forum

Von Tobias Arnhold → 10.22.2015
Viele meiner Kollegen (um die 90 %) nutzen bei schwierigen SQL Problemen nicht das SQL Forum, sondern versuchen sich lieber an inperformanten PL/SQL Code.

Die Gründe sind leicht erklärt: Zeitmangel!

Der kurzfristige Vorteil kann im Nachhinein aber sehr teuer / zeitaufwendig werden. Nämlich dann, wenn die schnelle Lösung mit erhöhten Datenmengen versagt und statt ursprünglich wenigen Sekunden plötzlich Minuten an Zeit verbraucht.

Hierbei möchte ich auf die goldene Regel von Tom Kyte referenzieren:
     1.) Nutze solange SQL wie es geht
     2.) Wenn SQL nicht mehr reicht, dann nehme PL/SQL
     3.) Wenn PL/SQL nicht mehr reicht, dann nehme JAVA oder irgendetwas Anderes was weiterhilft

Meine Anmerkung wäre die folgende zu Punkt 1.)
     1.)  Nutze solange SQL wie es geht und befrage bei Problemen das Oracle SQL Forum

Wie aber stelle ich eine Frage richtig?
Um auch richtige Hilfe zu erhalten, muss eine entsprechende Vorarbeit Ihrerseits geleistet werden.
Das heißt:
     1.) Beschreiben Sie das Problem und fokussieren Sie sich dabei auf das Kernproblem
     2.) Hinterlegen Sie Quelldaten und ihre gescheiterten SQL Versuche
     3.) Beschreiben Sie das Zielszenario (Ergebnis in Tabellenform)
Sie sollten mit 30 Minuten Vorbereitungszeit rechnen (das erste Mal wird etwas länger dauern).
Info: Achten Sie auch auf den Inhalt der Quelldaten.  :)

Sie können sich dabei an meinen Beispielen inspirieren lassen:
     Beispiel 1: Generate some kind of cartesian list
     Beispiel 2: wi (dd.mm.yyyy-dd.mm.yyyy)
     Beispiel 3: Check crossing time periods between rows

Der aufwendigste Teil bleibt immer wieder die Aufbereitung der Quell- und Zieldaten. Ich bin zwar kein Fan der WITH-Klausel aber bei der Hilfe im Forum wird Sie von den Entwicklern immer wieder verwendet. Nun wäre es die einfachste Vorgehensweise die Quelldaten immer mit Hilfe der WITH-Klausel aufbereitet zur Verfügung zu stellen. Denn dann könnten die Entwickler deren Hilfe ich in Anspruch nehme, viel schneller reagieren. Wobei auch so die Reaktionszeit bei durchschnittlich 10 Minuten liegt (siehe Beispiele).

Deshalb habe ich eine Funktionen gebaut die auf Basis einer Tabelle oder View die Quelldaten als WITH-Klausel aufbereitet.
create or replace function get_with_clause(p_table_name in varchar2, p_include_with_clause number default 1, p_rows in number default 10) return clob as
/* Dynamische WITH-Klausel mit SELECT FROM DUAL auf Basis einer vorhandenen Tabelle generieren
   Übergabeparameter: 
     p_table_name = Tabellename
     p_include_with_clause = 1 oder 0, wenn 1 dann mit WITH-Klausel ansonsten nur SELECT FROM DUAL
     p_rows  = Anzahl Zeilen die zurückgegeben werden sollen, wenn NULL, dann alle
*/
 l_sql1 varchar2(4000);
 l_sql2 clob;
begin 
  select 'SELECT ' || chr(13) 
    || 
       case 
        when p_include_with_clause = 1 then
         '''WITH ' || max(table_name) || ' AS ('' ||' || chr(13) 
        else 
         null
       end
    || 'REGEXP_REPLACE(DBMS_XMLGEN.CONVERT(XMLAGG(XMLELEMENT(E, ' || chr(13) 
       || 'CHR(13) || ''SELECT '' || CHR(13) || '
       || replace(listagg(
                case 
                  when data_type = 'NUMBER' 
                    then 'nvl(trim(to_char('||column_name||')),''NULL'') || ''  as ' || column_name || ',''|| CHR(13) || '
                  when data_type = 'VARCHAR2' 
                    then 'decode('||column_name||',NULL,''NULL'',''''''''||'||column_name||'||'''''''') || ''  as ' || column_name || ',''|| CHR(13) || '
                  when data_type = 'DATE' 
                    then 'decode('||column_name||',NULL,''NULL'',''''''''||to_char('||column_name||',''dd.mm.yyyy hh24:mi'')||'''''''') || '' as ' || column_name || ',''|| CHR(13) || '
                  else 
                    null
                end
                , ' '
          ) within group (order by rownum) || 'ZZ',',''|| CHR(13) || ZZ',' '' ||')
       || chr(13) 
       || '''FROM DUAL UNION ALL '''
       || chr(13) 
    || ')).EXTRACT(''//text()'').GETCLOBVAL(),1)||''XX'','' UNION ALL XX'','''')'
    ||
       case 
        when p_include_with_clause = 1 then
          '|| CHR(13) || '') ' || 'SELECT t1.* FROM ' || max(table_name) || ' t1 ORDER BY 1'''
        else 
          null
       end
    || chr(13) 
    || 'FROM ' 
    || max(table_name)
    || chr(13) 
    || case when p_rows is null then null else 'WHERE ROWNUM BETWEEN 1 AND ' || trim(to_char(p_rows)) end
  into l_sql1
  from user_tab_columns
  where table_name = p_table_name
  and data_type in ('NUMBER','VARCHAR2','DATE');
 
  execute immediate (l_sql1) into l_sql2;
 
  return l_sql2;
end get_with_clause;
Innerhalb der Funktion werden die Spalten der übergebenen Tabelle ausgelesen. Daraus generiere ich dann ein dynamisches SQL das mir die "select * from dual" - je Zeile generiert. Das Ergebnis ist ein CLOB mit einem ausführbaren SQL Code.

Unter 12c sollte es auch ohne Funktionsaufruf abbildbar sein (Grundlagen sie Blogpost von Carsten), ich konnte es aber wegen fehlen einer 12c Umgebung noch nicht abschließend testen. :(
with function get_with_clause(p_table_name in varchar2, p_include_with_clause number default 1, p_rows in number default 10) return clob as
 L_SQL1 VARCHAR2(4000);
 L_SQL2 CLOB;
BEGIN 
  SELECT 'SELECT ' || CHR(13) 
    || 
       case 
        when p_include_with_clause = 1 then
         '''WITH ' || MAX(table_name) || ' AS ('' ||' || CHR(13) 
        else 
         null
       end
    || 'REGEXP_REPLACE(DBMS_XMLGEN.CONVERT(XMLAGG(XMLELEMENT(E, ' || CHR(13) 
       || 'CHR(13) || ''SELECT '' || CHR(13) || '
       || replace(listagg(
                case 
                  when data_type = 'NUMBER' 
                    then 'nvl(trim(to_char('||column_name||')),''NULL'') || ''  as ' || column_name || ',''|| CHR(13) || '
                  when data_type = 'VARCHAR2' 
                    then 'decode('||column_name||',NULL,''NULL'',''''''''||'||column_name||'||'''''''') || ''  as ' || column_name || ',''|| CHR(13) || '
                  when data_type = 'DATE' 
                    then 'decode('||column_name||',NULL,''NULL'',''''''''||to_char('||column_name||',''dd.mm.yyyy hh24:mi'')||'''''''') || '' as ' || column_name || ',''|| CHR(13) || '
                  else 
                    null
                end
                , ' '
          ) WITHIN GROUP (ORDER BY ROWNUM) || 'ZZ',',''|| CHR(13) || ZZ',' '' ||')
       || CHR(13) 
       || '''FROM DUAL UNION ALL '''
       || CHR(13) 
    || ')).EXTRACT(''//text()'').GETCLOBVAL(),1)||''XX'','' UNION ALL XX'','''')'
    ||
       case 
        when p_include_with_clause = 1 then
          '|| CHR(13) || '') ' || 'SELECT t1.* FROM ' || MAX(table_name) || ' t1 ORDER BY 1'''
        else 
          null
       end
    || CHR(13) 
    || 'FROM ' 
    || MAX(table_name)
    || CHR(13) 
    || case when p_rows is null then null else 'WHERE ROWNUM BETWEEN 1 AND ' || trim(to_char(p_rows)) end
  INTO L_SQL1
  FROM user_tab_columns
  WHERE table_name = p_table_name
  AND DATA_TYPE IN ('NUMBER','VARCHAR2','DATE');
 
  EXECUTE IMMEDIATE (L_SQL1) INTO L_SQL2;
 
  RETURN L_SQL2;
end get_with_clause;
select get_with_clause('DEPARTMENT') as result from dual
Ergebnis Beispiel für Tabelle DEPT:
SELECT GET_WITH_CLAUSE( P_TABLE_NAME => 'DEPT', P_INCLUDE_WITH_CLAUSE => 1, P_ROWS => 100 ) as RESULT
FROM DUAL;

WITH DEPT AS (
SELECT 
10  as DEPTNO,
'ACCOUNTING'  as DNAME,
'NEW YORK'  as LOC FROM DUAL UNION ALL 
SELECT 
20  as DEPTNO,
'RESEARCH'  as DNAME,
'DALLAS'  as LOC FROM DUAL UNION ALL 
SELECT 
30  as DEPTNO,
'SALES'  as DNAME,
'CHICAGO'  as LOC FROM DUAL UNION ALL 
SELECT 
40  as DEPTNO,
'OPERATIONS'  as DNAME,
'BOSTON'  as LOC FROM DUAL
) SELECT t1.* FROM DEPT t1 ORDER BY 1

Info: Die Lösung funktioniert nur mit den Datentypen: NUMBER, VARCHAR2, DATE. Die restlichen Datentypen werden derzeit ignoriert.

Analytische Funktionen (Teil 3): Gruppen mit zufälliger Auswahl der Datenbasis

Von Tobias Arnhold → 10.07.2015
Das folgende Beispiel bezieht sich auf die Datenbasis meines ersten Post zu "Analytischen Funktionen".
Es geht darum, dass für das Jahr 2014 drei Gruppen (mit einem Hash-Wert je Gruppe) gebildet werden müssen.
Gruppe 1:
- 3 zufällig ausgewählte Bundesländer die mit B anfangen
Gruppe 2:
- 3 zufällig ausgewählte Bundesländer die mit S anfangen
Gruppe 3:
- 3 zufällig ausgewählte Bundesländer die NICHT mit B und S anfangen

Hier das dafür notwendige SQL:
SELECT
  BUNDESLAND,
  EINWOHNER,
  GRUPPE,
  /* Hash Generierung */
  DBMS_CRYPTO.HASH (UTL_RAW.CAST_TO_RAW (GRUPPE||'XYZ'), 1) AS HASH_WERT
FROM (
  SELECT
   JAHR,
   BUNDESLAND,
   EINWOHNER,
    /* Gruppe definieren */
    CASE 
      WHEN BUNDESLAND LIKE 'B%' 
      THEN 1
      WHEN BUNDESLAND LIKE 'S%'
      THEN 2
      ELSE 3
    END  AS GRUPPE,
   /* Zufällige Sortierung innerhalb der Gruppe */
   ROW_NUMBER() OVER (
        PARTITION BY
          CASE 
            WHEN BUNDESLAND LIKE 'B%' 
            THEN 1
            WHEN BUNDESLAND LIKE 'S%'
            THEN 2
            ELSE 3
          END 
        ORDER BY DBMS_RANDOM.VALUE(1,10)
    ) AS RN
  FROM AS_EINWO_BUNDESL_JAHR
  WHERE JAHR = 2014
)
WHERE RN <= 3
ORDER BY GRUPPE, BUNDESLAND

/* 
   Nicht vergessen bei der Verwendung von DBMS_CRYPTO.HASH: 
   grant execute on sys.dbms_crypto to APEX_SCHEMA; 
*/
Ergebnis:

BUNDESLAND EINWOHNER GRUPPE HASH_WERT
Baden-Württemberg 10666000 1 C5B1DF1A52DCC34C648FC79804F49A0A
Bayern 12643000 1 C5B1DF1A52DCC34C648FC79804F49A0A
Bremen 659000 1 C5B1DF1A52DCC34C648FC79804F49A0A
Sachsen 4045000 2 38FAEEE9CD02869F273DE5A44CF75218
Sachsen-Anhalt 2238000 2 38FAEEE9CD02869F273DE5A44CF75218
Schleswig-Holstein 2819000 2 38FAEEE9CD02869F273DE5A44CF75218
Hamburg 1762000 3 7DA2D9ED3366BAEA4B1FA0D6269F7F9F
Mecklenburg-Vorpommern 1594000 3 7DA2D9ED3366BAEA4B1FA0D6269F7F9F
Rheinland-Pfalz 3996000 3 7DA2D9ED3366BAEA4B1FA0D6269F7F9F

Im Endeffekt wird mit Hilfe der ROW_NUMBER() Funktion und DBMS_RANDOM.VALUE Funktion eine zufällige Verteilung geschaffen.

Analytische Funktionen (Teil 2): LISTAGG mit eindeutiger Liste

Von Tobias Arnhold → 10.01.2015
Die LISTAGG Funktion dient der Generierung von zusammenkonkatenierten Strings auf Basis einer Spalte. Wenn in der Spalte ein Wert mehrfach vorkommt, dann wird die Liste ebenfalls mit doppelten Werten generiert.

Im folgenden demonstriere ich ein Beispiel um dieses Problem zu lösen.

Beispieldaten - Land und Ort:
SELECT
 LAND, ORT
FROM STADT_LISTE 
ORDER BY 1,2;
Ergebnis:
LAND ORT
Belgien Bruxelles
Belgien Bruxelles
Polen Katowice
Polen Wegliniec
Schweiz Basel
Schweiz Bern
Schweiz Riehen
Schweiz Thayngen
Schweiz Thayngen

Ziel ist es nun, nur die Länder mit jeweils einer Liste an Orten auszugeben. Unglücklicherweise hat meine Tabelle die Orte Bruxelles und Thayngen doppelt hinterlegt. Mit Hilfe der ROW_NUMBER() Funktion selektiere ich diese Werte vor der LISTAGG-Funktion heraus.
SELECT
  LAND,
  REPLACE(':'||LISTAGG(ORT_UNGUELTIG,':')  WITHIN GROUP (ORDER BY ORT_UNGUELTIG)||':','::',NULL) AS ORT_LISTE_UNGUELTIG,
  REPLACE(':'||LISTAGG(ORT_GUELTIG,':')  WITHIN GROUP (ORDER BY ORT_GUELTIG)||':','::',NULL) AS ORT_LISTE_GUELTIG
FROM (
  SELECT  
   LAND, 
   ORT AS ORT_UNGUELTIG,
   CASE WHEN 
         ROW_NUMBER() OVER (PARTITION BY LAND, ORT ORDER BY ORT) = 1
         THEN ORT
         ELSE NULL
    END AS ORT_GUELTIG
  FROM STADT_LISTE 
)
GROUP BY LAND
ORDER BY LAND;
Ergebnis:
LAND ORT_LISTE_UNGUELTIG ORT_LISTE_GUELTIG
Belgien :Bruxelles:Bruxelles: :Bruxelles:
Polen :Katowice:Wegliniec: :Katowice:Wegliniec:
Schweiz :Basel:Bern:Riehen:Thayngen:Thayngen: :Basel:Bern:Riehen:Thayngen:

Weiterführende Infos zum Thema LISTAGG und Analytische Funktionen findet Ihr hier: Die besten HowTo's rund um fortgeschrittene SQL-Techniken

Analytische Funktionen (Teil 1): SUM mit CASE WHEN

Von Tobias Arnhold → 9.27.2015
Es gibt wie in meinem letzten Post beschrieben, sehr viele Artikel zu analytischen Funktionen. Diese zeigen die Fähigkeiten aber nur an der Oberfläche. Deshalb möchte ich in den nächsten Monaten die besten Tricks mal beispielhaft abbilden.

Als Grundlage habe ich eine Tabelle mit Einwohnern je Bundesland und Jahr. Als Quelle gilt das Statistische Bundesamt.

SELECT
 JAHR,
 BUNDESLAND,
 EINWOHNER
FROM AS_EINWO_BUNDESL_JAHR
WHERE JAHR = 2014
ORDER BY 1,2
JAHR BUNDESLAND EINWOHNER
2014 Baden-Württemberg 10.666.000
2014 Bayern 12.643.000
2014 Berlin 3.443.000
2014 Brandenburg 2.449.000
2014 Bremen 659.000
2014 Hamburg 1.762.000
2014 Hessen 6.059.000
2014 Mecklenburg-Vorpommern 1.594.000
2014 Niedersachsen 7.799.000
2014 Nordrhein-Westfalen 17.579.000
2014 Rheinland-Pfalz 3.996.000
2014 Saarland 989.000
2014 Sachsen 4.045.000
2014 Sachsen-Anhalt 2.238.000
2014 Schleswig-Holstein 2.819.000
2014 Thüringen 2.156.000

In meinem ersten Beispiel möchte ich eine bedingte Summierung zeigen. Dazu soll für die Top 5 Bundesländer mit der höchsten Einwohnerzahl das Verhältnis zur Gesamtanzahl aller Bundesbürger in Prozent aufgezeigt werden. Zusätzlich werden die TOP 5 Bundesländer FETT markiert.

Info: Wenn meine Beispiel nicht gefallen, dann kann ich es verstehen. Ich löse für gewöhnlich Probleme und denke sie mir nicht aus. :)
SELECT
 BUNDESLAND,
 EINWOHNER,
 SUM(EINWOHNER) OVER () as EINWOHNER_GESAMT,
 /* Beispiel: Summe über Einwohner nur wenn TOP5 = 1 */
 SUM(CASE WHEN IN_TOP5 = 1 THEN EINWOHNER ELSE 0 END) OVER () AS EINWOHNER_TOP5,
 /* Prozentwertberechnung */
 round(SUM(CASE WHEN IN_TOP5 = 1 THEN EINWOHNER ELSE 0 END) OVER ()  / SUM(EINWOHNER) OVER () * 100,0) IN_PROZ
FROM
(
  SELECT
    JAHR,
    /* Generierung der TOP 5 mit B-Tag */
    case when 
          row_number () over (order by EINWOHNER desc) <= 5
         then
          ''||BUNDESLAND||''
         else
          BUNDESLAND
    end as BUNDESLAND,
    /* Ausgabe TOP-5 mit 1 Sonst 0 */
    case when 
          row_number () over (order by EINWOHNER desc) <= 5
         then
          1
         else
          0
    end as IN_TOP5,
    EINWOHNER
  FROM AS_EINWO_BUNDESL_JAHR
  WHERE JAHR = 2014
)
ORDER BY 1, 3 desc
BUNDESLAND EINWOHNER EINWOHNER_GESAMT EINWOHNER_TOP5 IN_PROZ
<b>Baden-Württemberg</b> 10.666.000 80.896.000 54.746.000 68
<b>Bayern</b> 12.643.000 80.896.000 54.746.000 68
Berlin 3.443.000 80.896.000 54.746.000 68
<b>Hessen</b> 6.059.000 80.896.000 54.746.000 68
<b>Niedersachsen</b> 7.799.000 80.896.000 54.746.000 68
<b>Nordrhein-Westfalen</b> 17.579.000 80.896.000 54.746.000 68
Brandenburg 2.449.000 80.896.000 54.746.000 68
Bremen 659.000 80.896.000 54.746.000 68
Hamburg 1.762.000 80.896.000 54.746.000 68
Mecklenburg-Vorpommern 1.594.000 80.896.000 54.746.000 68
Rheinland-Pfalz 3.996.000 80.896.000 54.746.000 68
Saarland 989.000 80.896.000 54.746.000 68
Sachsen 4.045.000 80.896.000 54.746.000 68
Sachsen-Anhalt 2.238.000 80.896.000 54.746.000 68
Schleswig-Holstein 2.819.000 80.896.000 54.746.000 68
Thüringen 2.156.000 80.896.000 54.746.000 68

Hmm die Reihenfolge mit dem Order By hätte ich etwas besser auswählen können. :O

Die besten HowTo's rund um fortgeschrittene SQL-Techniken

Von Tobias Arnhold → 9.25.2015
Im Zuge des aktuellen Community Tips, möchte ich mal eine Liste an HowTo's, Tips und Tricks rund um die verschiedenen aktuellen
SQL-Techniken veröffentlichen. Dabei habe ich mich möglichst auf deutsche Lektüre fokussiert. Am häufigsten habe ich Artikel von Carsten Czarski gefunden, was wohl wenig verwunderlich ist. :)
Die folgenden Links richten sich an jene Entwickler, die mehr als SQL-92 aus Ihrer Oracle Datenbank rausholen möchten.


Analytische SQL-Funktionen
 - Daten zusammenfassen mit Aggregatsfunktionen
 - Mächtige Berichte mit "Analytischen Funktionen"
 - Analytische Funktionen - eine Einführung
 - Analytische Funktionen - Einführung
 - Einsatz analytischer Funktionen
 - Probably the Coolest SQL Feature: Window Functions (Englisch)

Volltextsuche
 - Ähnlichkeitssuche in SQL-Abfragen: Oracle TEXT für alle!
 - Volltextrecherche und mehr: Wozu man Oracle Text nutzen kann
 - Oracle Text - Einführung
 - Ähnlichkeitssuche mit Oracle Text
 - "Unscharfe Suche" in Datenbeständen

Räumliche Abfragen (Geodaten)
 - oracle-spatial.blogspot.de
 - spatialdbadvisor.com (Englisch)
 - SDO_GEOMETRY für Newbies
 - Was kann der Oracle Locator (Englisch)

XML-Funktionen
 - Working with XML files and APEX - Part 1: Upload (Englisch)
 - Working with XML files and APEX - Part 2: Selecting data from XMLType column with XMLTable (Englisch)
 - XML-Dokumente relational aufbereiten: mit SQL!
 - XML-Strukturen analysieren - mit SQL!

JSON-Funktionen
 - APEX_JSON ohne APEX: JSON parsen mit SQL und PL/SQL
 - APEX_JSON ohne APEX: JSON erzeugen mit SQL und PL/SQL

 - Native JSON-Unterstützung in der Oracle-Datenbank 12c (12.1.0.2)
 - Oracle 12.1.0.2 ist da: Ein Einblick in die JSON-Unterstützung
 - Speed Up Your APEX apps with JSON and Mustache.js

SQL Pattern Matching (ab 12.1)
 - Datenmuster finden: SQL Pattern Matching in Oracle12c
 - Oracle12c: Was für SQL- und PL/SQL-Entwickler einfacher wird
 - Pattern Matching (MATCH_RECOGNIZE) in Oracle Database 12c Release 1 (Englisch)

SQL MODEL-Klausel
 - Kalkulationen, Simulationen und mehr - in APEX: SQL MODEL Klausel
 - SQL Model Clause Tutorial (Englisch)
 - Rechnen wie in Excel - in einer SQL-Abfrage
 - SQL Model Clause Tutorial
 - Model Klausel - Der Excel-Killer von Oracle?
 - Forum Lösung - Gantt Chart überschneidende Einträge (Englisch)

Stringverkettungen
 - LISTAGG function in 11g release 2 (Englisch)
 - SQL LISTAGG mit CLOB-Ausgabe - kein VARCHAR2-Limit mehr
 - XML CLOB Trick - Custom CSV Export in APEX


String to Table
 - Split comma delimited strings in a table in Oracle
 - emulating string-to-table functionality using sql
 - When APEX_UTIL.STRING_TO_TABLE is not enough

Ähnlichkeitssuche (Beispiel: Jaro Winkler)
 - UTL_MATCH : String Matching by Testing Levels of Similarity/Difference (Englisch)
 - Oracle UTL_MATCH (Englisch)

Hierarchische Abfragen (CONNECT BY)
 - Treewalking mit SQL (Hierarchische Strukturen) 
 - Oracle: connect by (Hierarchische Queries)
 - Hierarchische Abfragen in Oracle11g Rel2: Recursive WITH clause 

Regular Expressions
 - Reguläre Ausdrücke in der Oracle Datenbank in SQL verwenden
 - Reguläre Ausdrücke ... in der Datenbank!
 - Reguläre Ausdrücke in Application Express 
 - Regular Expressions in Oracle

Kreuztabellen (Pivot / Unpivot)
 - Kreuztabellen in Oracle11g: SQL PIVOT-Klausel
 - Pivoting in 11g - Zeilen zu Spalten
 - pivot and unpivot queries in 11g (Englisch)
 - Dynamic SQL Pivoting – Stealing Anton’s Thunder (Englisch)
 - APEX Beispielanwendung

Zufallszahlen
 - Arbeiten mit DBMS_CRYPTO
 - Generating random numbers and strings in Oracle (Englisch)
 - Oracle DBMS_CRYPTO (Englisch) und Oracle DBMS_RANDOM (Englisch)

Zeilengenerierung
 - Oracle Row Generator Techniques (Englisch)